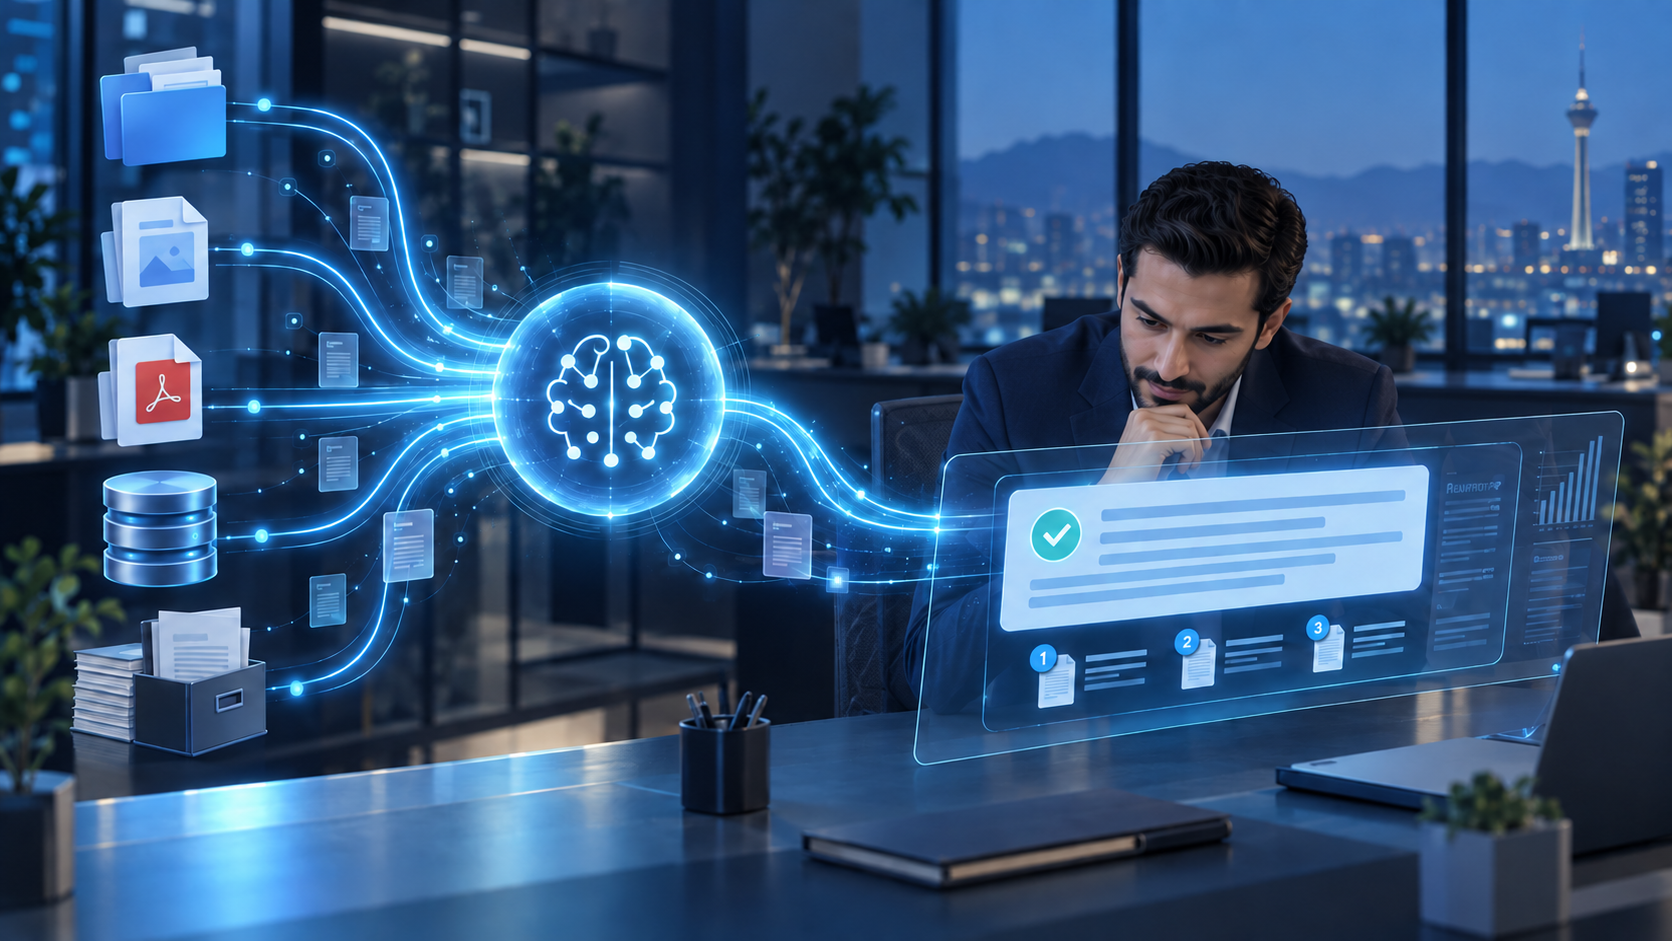
کاربری از یک دستیار هوشمند میپرسد: «براساس آخرین دستورالعمل، سقف اختیار خرید واحد ما چقدر است؟» یک مدل زبانی بزرگ یا LLM ممکن است مفهوم سقف اختیار را بفهمد و پاسخی روان تولید کند، اما بهطور پیشفرض نمیداند آخرین نسخه دستورالعمل داخلی سازمان کدام است، کاربر چه نقشی دارد و پاسخ باید به کدام بند سند استناد کند.
RAG برای پر کردن همین فاصله به کار میرود. این الگو پیش از تولید پاسخ، بخشهای مرتبط را از منابع تعیینشده بازیابی میکند و همراه پرسش در اختیار مدل زبانی قرار میدهد. در نتیجه، پاسخ میتواند به دانش بهروزتر و اختصاصی سازمان متکی باشد و منبع آن نیز به کاربر نمایش داده شود. بااینحال، RAG بهتنهایی تضمینکننده صحت نیست؛ کیفیت سند، شیوه بخشبندی، جستوجو، مجوز دسترسی و ارزیابی پاسخ همچنان تعیینکنندهاند.
RAG دقیقاً چیست و چه مرزی دارد؟
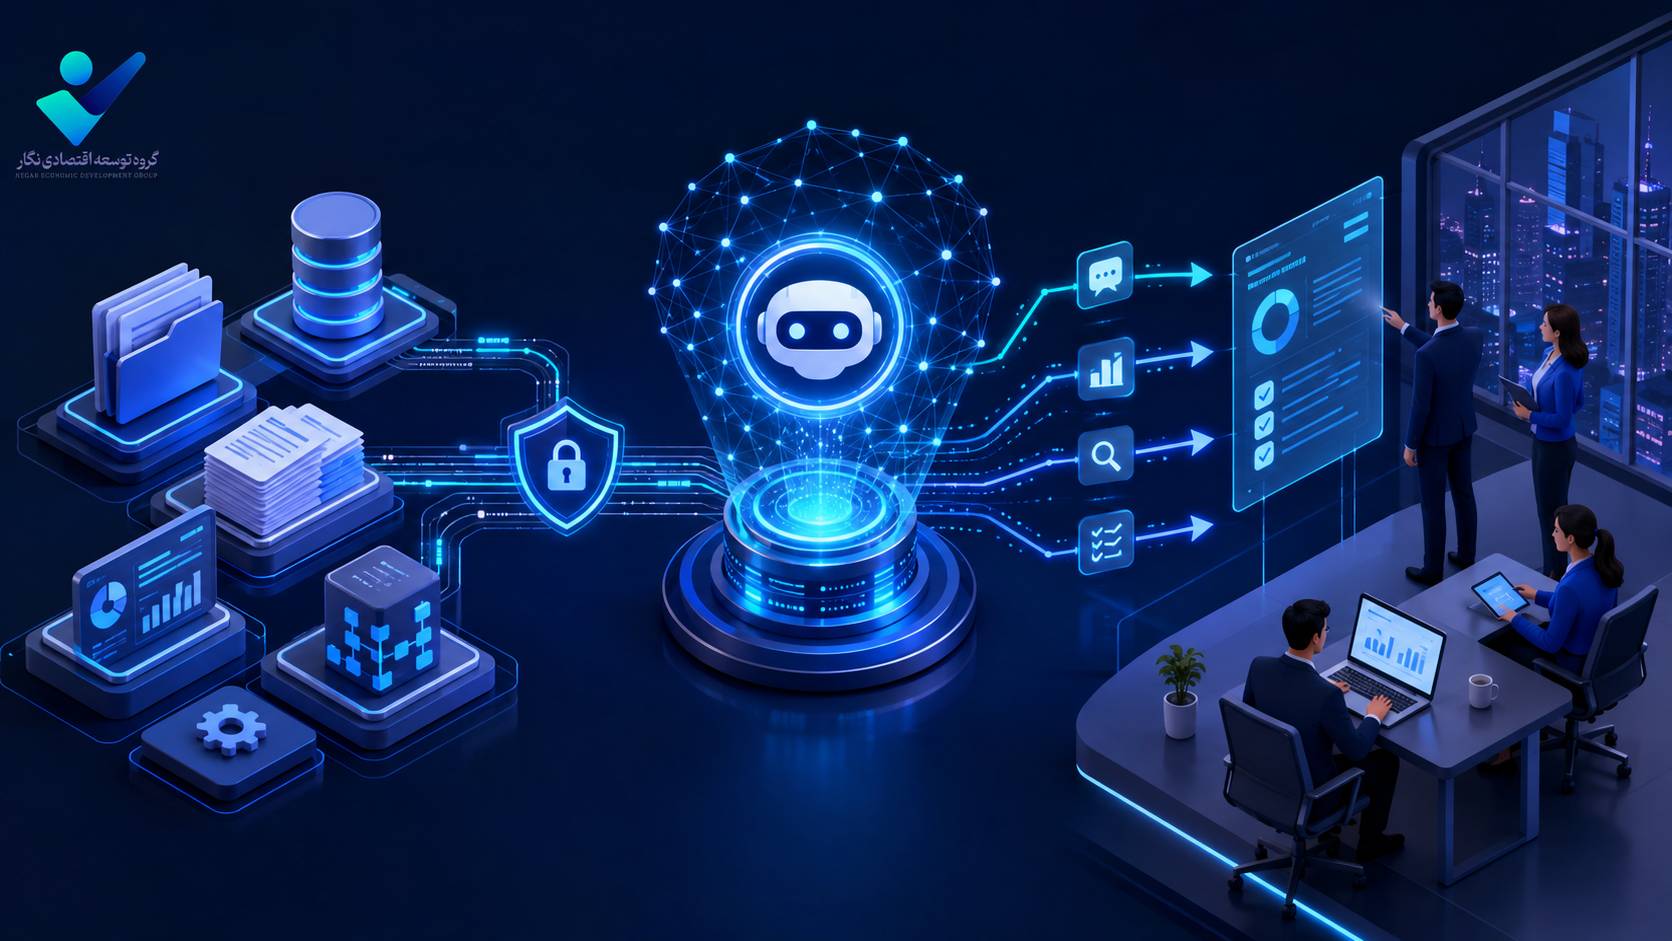
RAG مخفف Retrieval-Augmented Generation و به معنی «تولید تقویتشده با بازیابی» است. در این معماری، سامانه ابتدا اطلاعات مرتبط را از یک پایگاه دانش، مخزن سند، سامانه جستوجو یا منبع داده مجاز پیدا میکند؛ سپس پرسش کاربر و محتوای بازیابیشده را در قالب زمینه به مدل زبانی میدهد تا پاسخ را تولید کند.
بنابراین RAG خودِ مدل زبانی، پایگاه داده یا موتور جستوجو نیست؛ یک الگوی معماری است که این اجزا را کنار هم قرار میدهد. همچنین معمولاً به معنی آموزش دوباره مدل روی تمام اسناد سازمان نیست. اسناد در یک مسیر جداگانه آماده و نمایهسازی میشوند و هنگام طرح هر پرسش، فقط بخشهای مرتبط به مدل ارسال میشوند.
مرز مهم دیگر این است که RAG پاسخ نادرست را حذف نمیکند. اگر بخش نامرتبط بازیابی شود، نسخه قدیمی بهعنوان منبع معتبر باقی مانده باشد یا مدل از متن بازیابیشده فراتر برود، پاسخ همچنان میتواند ناقص یا اشتباه باشد. RAG امکان کنترل و بررسی را بیشتر میکند، اما جایگزین حاکمیت محتوا و آزمون مستمر نیست.
مسئله سازمانی چیست؛ چرا دانش عمومی مدل کافی نیست؟
دانش یک LLM از دادههای آموزشی آن میآید و معمولاً شامل جزئیات محرمانه یا اختصاصی سازمان نیست. حتی اگر مدل درباره مدیریت منابع انسانی، خرید یا قراردادها اطلاعات عمومی داشته باشد، از آخرین آییننامه، فرم جاری، استثناهای داخلی یا تغییرات همین هفته سازمان خبر ندارد.
افزودن همه این اطلاعات به یک پرامپت نیز راهحل پایداری نیست. اسناد ممکن است هزاران صفحه باشند، مرتب تغییر کنند و سطح دسترسی متفاوتی داشته باشند. از طرف دیگر، ارسال محتوای زیاد میتواند هزینه و زمان پاسخ را افزایش دهد و اطلاعات نامرتبط را وارد زمینه مدل کند. RAG بهجای فرستادن کل مخزن، تلاش میکند فقط شواهد مرتبط با همان پرسش را پیدا کند.
RAG چگونه کار میکند؟
یک راهکار RAG معمولاً دو جریان اصلی دارد: آمادهسازی دانش و پاسخگویی به پرسش.
جریان آمادهسازی دانش
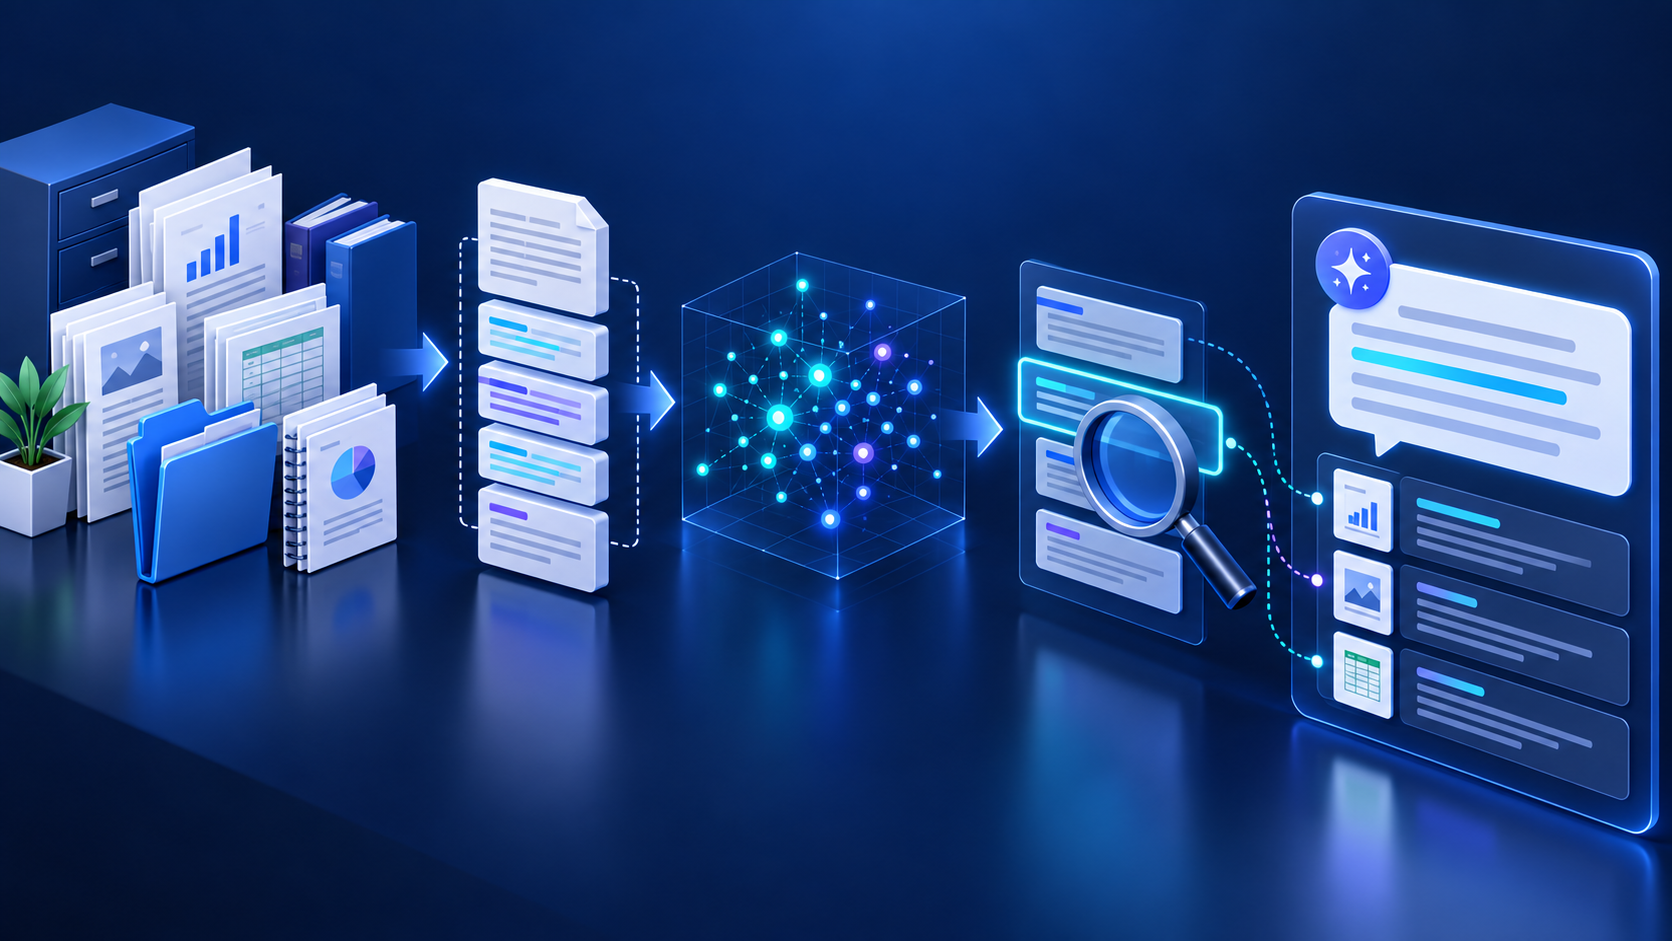
1. انتخاب منابع: اسناد معتبر مانند آییننامهها، دستورالعملها، رویهها، پرسشهای متداول یا صفحات پرتال مشخص میشوند.
2. استخراج و پاکسازی: متن از فایلهایی مانند PDF، Word یا HTML استخراج و عناصر کمارزش مانند سربرگهای تکراری، نویز OCR و نسخههای منسوخ حذف میشود.
3. بخشبندی یا Chunking: هر سند به قطعههای کوچکتر و معنادار تقسیم میشود تا بخش مناسب با دقت بیشتری بازیابی شود.
4. افزودن متادیتا: عنوان، نوع سند، واحد مالک، تاریخ اعتبار، شماره نسخه، سطح محرمانگی و نشانی منبع به هر قطعه متصل میشود.
5. Embedding و نمایهسازی: متن قطعهها به نمایش عددی تبدیل و همراه متن و متادیتا در نمایه جستوجو ذخیره میشود.
جریان پاسخگویی
1. کاربر پرسش را مطرح میکند و سامانه هویت و مجوز او را تشخیص میدهد.
2. پرسش برای جستوجو آماده میشود؛ گاهی بازنویسی یا به چند پرسش کوچکتر تقسیم میشود.
3. جستوجوی برداری، کلمهای یا ترکیبی، قطعههای محتمل را پیدا میکند.
4. نتایج بر اساس ارتباط، متادیتا، تازگی و قواعد دسترسی فیلتر و رتبهبندی میشوند.
5. چند قطعه برتر همراه پرسش و دستورهای پاسخگویی به مدل داده میشوند.
6. مدل پاسخ را تولید میکند و سامانه منبع، صفحه یا بند پشتیبان را نمایش میدهد.
این ترتیب در پیادهسازیهای مختلف تغییر میکند، اما اصل ثابت است: ابتدا شواهد مناسب پیدا میشود و سپس پاسخ با اتکا به آن ساخته میشود.
بازیابی، رتبهبندی و تولید پاسخ چه تفاوتی دارند؟
کیفیت نهایی حاصل عملکرد سه بخش جداگانه است. بازیابی باید قطعههایی را پیدا کند که احتمالاً پاسخ در آنها وجود دارد. رتبهبندی باید بهترین موارد را بالاتر قرار دهد و محتوای تکراری یا کمارتباط را کنار بگذارد. تولید پاسخ نیز باید از شواهد انتخابشده استفاده کند، تناقضها را پنهان نکند و در نبود اطلاعات کافی، عدم قطعیت را اعلام کند.
اگر پاسخ نادرست است، نباید فوراً مدل زبانی را مقصر دانست. ممکن است قطعه درست اصلاً بازیابی نشده باشد، نتیجه مرتبط در رتبه پایین قرار گرفته باشد یا دستور پاسخگویی اجازه داده باشد مدل بدون پشتوانه نتیجهگیری کند. به همین دلیل ارزیابی باید هر مرحله و همچنین تجربه نهایی کاربر را جداگانه بررسی کند.
H2: Chunking، Embedding و منبعدهی چه نقشی دارند؟
Chunking یعنی تقسیم سند به قطعههای قابل بازیابی. قطعه بسیار بزرگ ممکن است چند موضوع متفاوت را در خود داشته باشد و زمینه مدل را شلوغ کند. قطعه بسیار کوچک نیز ممکن است عنوان، شرط یا استثنای لازم را از پاسخ جدا کند. راهکار مناسب به ساختار سند بستگی دارد؛ برای نمونه، بخشبندی براساس تیتر و بند معمولاً برای آییننامه منسجمتر از برش ثابت و بدون توجه به ساختار است.
Embedding نمایش عددی معنا و محتوای متن است. با استفاده از آن، پرسشی مانند «چه کسی باید خرید را تأیید کند؟» میتواند به بندی برسد که در آن از عبارت «سطح تصویب درخواست» استفاده شده است، حتی اگر واژههای دقیق یکسان نباشند. بااینحال، مدل Embedding باید با زبان، نوع محتوا و نیاز واقعی سازمان آزمایش شود؛ عملکرد خوب روی متن انگلیسی الزاماً به معنی عملکرد مشابه روی اسناد فارسی نیست.
منبعدهی نیز فقط افزودن نام فایل در انتهای پاسخ نیست. ارجاع مفید باید کاربر را به سند معتبر، نسخه درست و در صورت امکان صفحه یا بند پشتیبان برساند. بهتر است قطعه بازیابیشده، شناسه سند، تاریخ اعتبار و نشانی اصلی را با خود حمل کند تا پاسخ قابل بررسی باشد.
کیفیت داده، نسخه معتبر و متادیتا چگونه بر RAG اثر میگذارند؟
RAG نمیتواند آشفتگی دانش سازمانی را پنهان کند. اگر سه نسخه متعارض از یک دستورالعمل در مخزن وجود داشته باشد، سامانه ممکن است هر سه را بازیابی کند. اگر تاریخ اعتبار یا مالک سند ثبت نشده باشد، تشخیص نسخه درست دشوار میشود. در این شرایط، افزودن مدل قویتر لزوماً مسئله را حل نمیکند.
پیش از نمایهسازی باید مشخص شود کدام منابع معتبرند، نسخه منسوخ چگونه کنار گذاشته میشود، مسئول بهروزرسانی کیست و تغییر سند چه زمانی به نمایه جستوجو میرسد. متادیتای استاندارد برای واحد مالک، موضوع، تاریخ، وضعیت اعتبار و سطح دسترسی، هم بازیابی را دقیقتر میکند و هم امکان کنترل و گزارشگیری میدهد.
کنترل دسترسی در RAG کجا باید اعمال شود؟
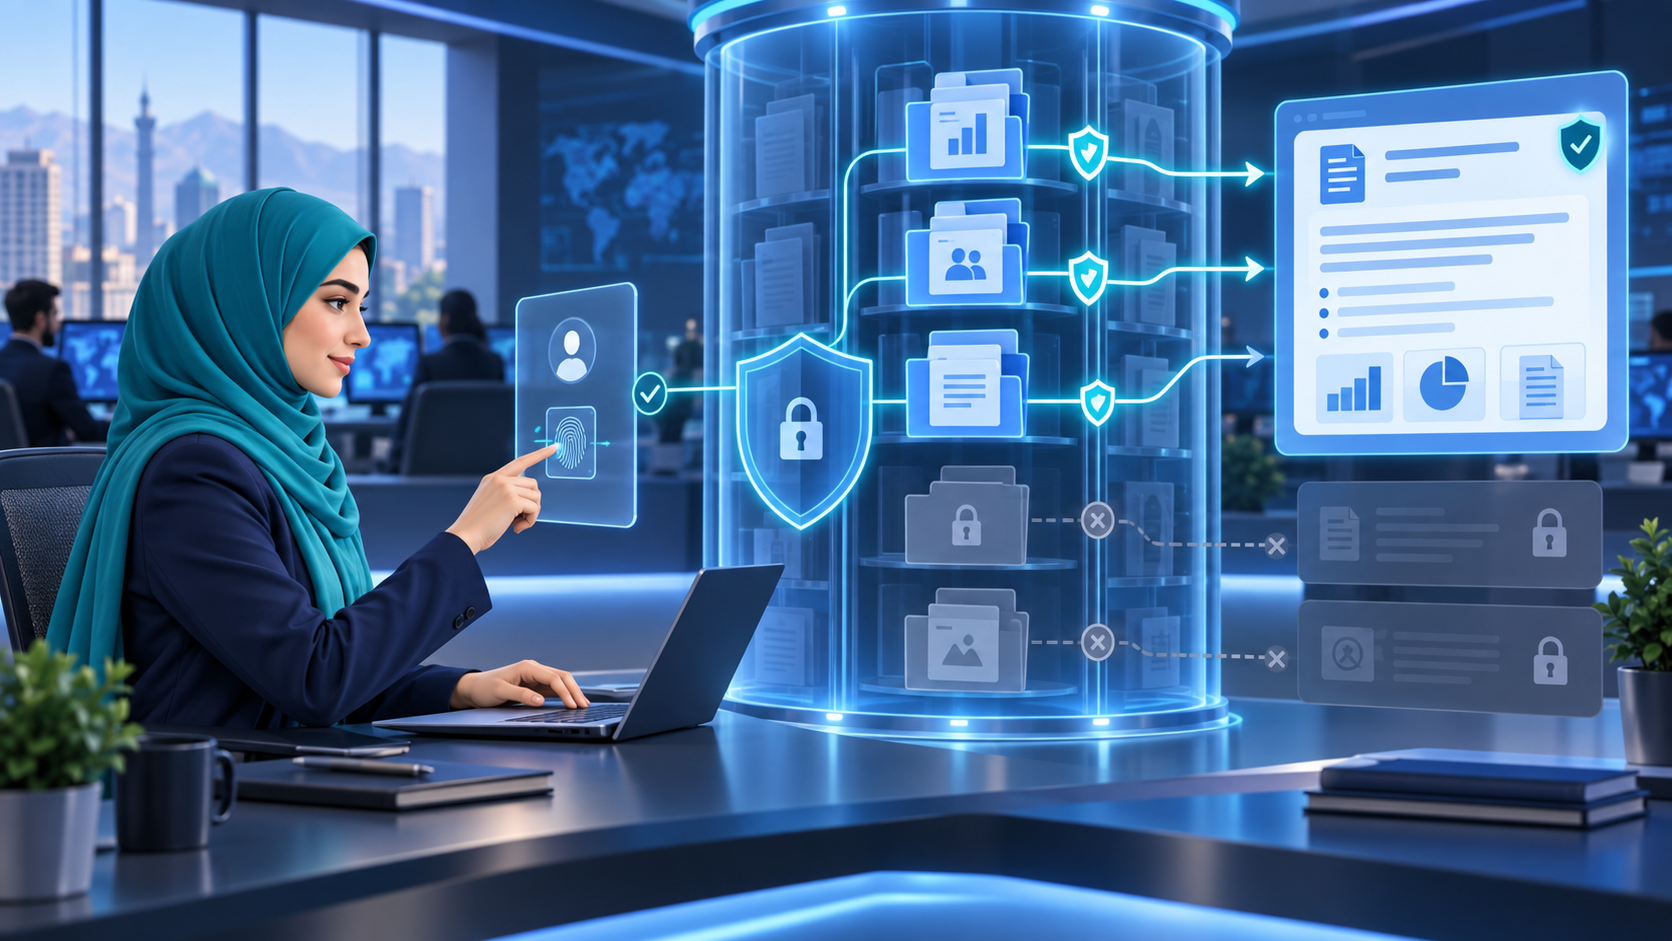
کنترل دسترسی باید پیش از ارسال محتوا به مدل اعمال شود، نه فقط هنگام نمایش پاسخ. اگر کاربر مجاز به مشاهده سند حقوق و دستمزد نیست، قطعههای آن سند نباید وارد نتایج بازیابی یا زمینه مدل شوند. فیلترکردن دیرهنگام پاسخ، ریسک افشای ناخواسته اطلاعات را از بین نمیبرد.
معماری باید هویت کاربر، نقش، گروه سازمانی و سیاست دسترسی منبع را به فرآیند جستوجو منتقل کند. ثبت پرسشها، منابع بازیابیشده و پاسخها نیز برای بررسی رخداد و بهبود کیفیت مفید است؛ اما خود این گزارشها ممکن است حاوی داده حساس باشند و باید سیاست نگهداری و دسترسی جداگانه داشته باشند.
RAG چه تفاوتی با جستوجوی کلمهای و Fine-tuning دارد؟
رویکرد | مسئله اصلی که حل میکند | نکته مهم |
جستوجوی کلمهای | یافتن اسناد دارای واژه یا عبارت مشخص | برای عبارات دقیق مناسب است، اما ممکن است هممعنیها و زبان طبیعی کاربر را از دست بدهد |
RAG | بازیابی شواهد مرتبط و ساخت پاسخ مبتنی بر آنها | منابع را میتوان بدون آموزش دوباره مدل بهروزرسانی کرد و ارجاع نمایش داد |
Fine-tuning | تغییر الگوی رفتار، سبک یا عملکرد مدل برای یک وظیفه | معمولاً راه اصلی برای تزریق مداوم نسخههای جدید اسناد نیست و همچنان به ارزیابی نیاز دارد |
این رویکردها رقیب مطلق یکدیگر نیستند. یک سامانه RAG میتواند جستوجوی کلمهای و برداری را ترکیب کند و در صورت نیاز از مدل تنظیمشده نیز بهره ببرد. انتخاب باید براساس مسئله، داده، هزینه، امنیت و معیار پذیرش انجام شود.
یک مثال سازمانی؛ پاسخ درباره آخرین دستورالعمل خرید
فرض کنیم کاربر میپرسد: «برای خرید تجهیزات بالاتر از مبلغ مشخص چه تأییدهایی لازم است؟» سامانه ابتدا هویت کاربر را دریافت میکند و جستوجو را به اسناد مجاز و معتبر محدود میسازد. سپس قطعههای مرتبط از آخرین دستورالعمل خرید، ماتریس اختیار و راهنمای ثبت درخواست را بازیابی میکند.
پس از رتبهبندی، مدل پاسخ را با ذکر مراحل و استثناها مینویسد و سه منبع را نمایش میدهد. اگر دستورالعمل و ماتریس اختیار با هم تعارض داشته باشند، پاسخ نباید یکی را حدس بزند؛ باید تعارض را اعلام و کاربر را به مالک فرآیند ارجاع دهد. این رفتار از خود RAG بهصورت خودکار حاصل نمیشود و باید در قواعد و آزمونهای سامانه تعریف شود.
برای سنجش کیفیت RAG چه معیارهایی لازم است؟
تعداد مکالمه یا سرعت پاسخ بهتنهایی کافی نیست. حداقل چهار سطح باید سنجیده شود:
1. کیفیت بازیابی: آیا قطعه حاوی پاسخ در میان نتایج برتر قرار گرفته است؟
2. ارتباط زمینه: چه مقدار از محتوای ارسالی به مدل واقعاً با پرسش مرتبط بوده است؟
3. اتکای پاسخ به منبع: آیا ادعاهای اصلی پاسخ در شواهد بازیابیشده پشتیبانی میشوند؟
4. ارزش برای کاربر: آیا زمان یافتن پاسخ کاهش یافته و کاربر توانسته اقدام درست بعدی را انجام دهد؟
مجموعه آزمون باید پرسشهای واقعی، ابهامها، پرسشهای بدون پاسخ، اسناد متعارض و تلاش برای دسترسی غیرمجاز را پوشش دهد. نتیجه یک میانگین کلی نباید خطاهای پرریسک را پنهان کند.
اشتباهات رایج در اجرای RAG چیست؟
ورود همه اسناد بدون تعیین اعتبار: مخزن بزرگتر الزاماً پاسخ بهتر نمیدهد. اسناد قدیمی و متعارض کیفیت بازیابی را کاهش میدهند.
انتخاب Chunking ثابت برای همه محتواها: قرارداد، آییننامه، جدول و صورتجلسه ساختار یکسانی ندارند و ممکن است به روشهای متفاوت نیاز داشته باشند.
اتکا به جستوجوی برداری بهتنهایی: شماره بخشنامه، کد کالا یا عبارت حقوقی گاهی با جستوجوی دقیق بهتر پیدا میشود. جستوجوی ترکیبی باید آزمایش شود.
نادیدهگرفتن مجوز در مرحله بازیابی: کنترل دسترسی فقط در رابط کاربر کافی نیست و باید روی نتیجه جستوجو اعمال شود.
نمایش ارجاع غیرقابل بررسی: ذکر نام کلی سند بدون نسخه، صفحه یا نشانی معتبر، اعتماد قابل سنجش ایجاد نمیکند.
ارزیابی فقط با چند نمونه موفق: پایلوت باید موارد بدون جواب، ابهام، تعارض و خطاهای امنیتی را نیز شامل شود.
برای شروع با دامنه محدود چه گامی پیشنهاد میشود؟
سناریویی انتخاب کنید که پرسشهای پرتکرار، منابع مشخص، مالک محتوای معلوم و ریسک قابل کنترل داشته باشد؛ برای مثال پاسخگویی به یک مجموعه محدود از آییننامههای منابع انسانی یا خرید. ابتدا اسناد معتبر و نسخههای منسوخ را جدا کنید، سپس چند ده پرسش واقعی با پاسخ مرجع بسازید و Chunking، جستوجو و منبعدهی را روی آنها آزمایش کنید.
در نسخه نخست بهتر است سامانه فقط پاسخ و منبع ارائه دهد و در نبود شواهد کافی، کاربر را به کارشناس ارجاع دهد. پس از رسیدن به معیارهای پذیرش میتوان دامنه سند، گروه کاربران و اتصال به فرآیندهای دیگر را مرحلهبهمرحله توسعه داد.
پرسشهای متداول
آیا RAG همان آموزش مدل روی اسناد سازمان است؟
خیر. در RAG معمولاً اسناد جداگانه نمایهسازی میشوند و هنگام هر پرسش، بخشهای مرتبط بهعنوان زمینه در اختیار مدل قرار میگیرند. آموزش یا Fine-tuning فرآیند متفاوتی دارد.
آیا RAG جلوی توهم مدل را میگیرد؟
RAG میتواند با فراهمکردن شواهد معتبر احتمال پاسخ بیپشتوانه را کاهش دهد، اما آن را صفر نمیکند. ارزیابی، دستور پاسخگویی، اعلام عدم قطعیت و کنترل انسانی همچنان لازماند.
آیا برای RAG حتماً به پایگاه داده برداری نیاز است؟
خیر. معماری میتواند از جستوجوی کلمهای، برداری یا ترکیبی استفاده کند. انتخاب به نوع پرسش، ساختار اسناد و نتایج آزمون بستگی دارد.
مهمترین پیشنیاز اجرای RAG چیست؟
وجود منابع معتبر و قابل مدیریت، مسئله روشن، کاربران مشخص و مجموعه پرسشهای آزمون نقطه شروع است. فناوری بدون این موارد فقط دسترسی سریعتری به آشفتگی موجود ایجاد میکند.
برای اسناد فارسی چه نکتهای مهمتر است؟
کیفیت استخراج متن، یکسانسازی نویسهها، حفظ ساختار تیتر و جدول، و آزمون مدل Embedding روی پرسشها و اسناد واقعی فارسی اهمیت ویژه دارد.
جمعبندی
RAG پلی میان توان زبانی مدل و دانش واقعی سازمان است. این معماری ابتدا شواهد مرتبط را از منابع مجاز پیدا میکند و سپس پاسخ را با اتکا به آنها میسازد. ارزش آن در سه قابلیت اصلی است: بهروزرسانی دانش بدون آموزش دوباره مدل، ارائه منبع قابل بررسی و اعمال کنترل بیشتر بر دادهای که وارد پاسخ میشود.
بااینحال، موفقیت پروژه به کیفیت اسناد، Chunking، Embedding، جستوجو، متادیتا، دسترسی و ارزیابی وابسته است. اگر سازمان شما میخواهد از RAG شروع کند، یک دامنه محدود و قابل سنجش انتخاب کنید و پیش از توسعه گسترده، کیفیت بازیابی و پاسخ را با پرسشهای واقعی بسنجید. برای درک جایگاه این معماری در محصول نهایی، مقاله «تفاوت دستیار هوشمند سازمانی و چتبات عمومی چیست؟» را نیز مطالعه کنید.

دیدگاهها
نظر یا پرسش خود را درباره این مقاله ثبت کنید.